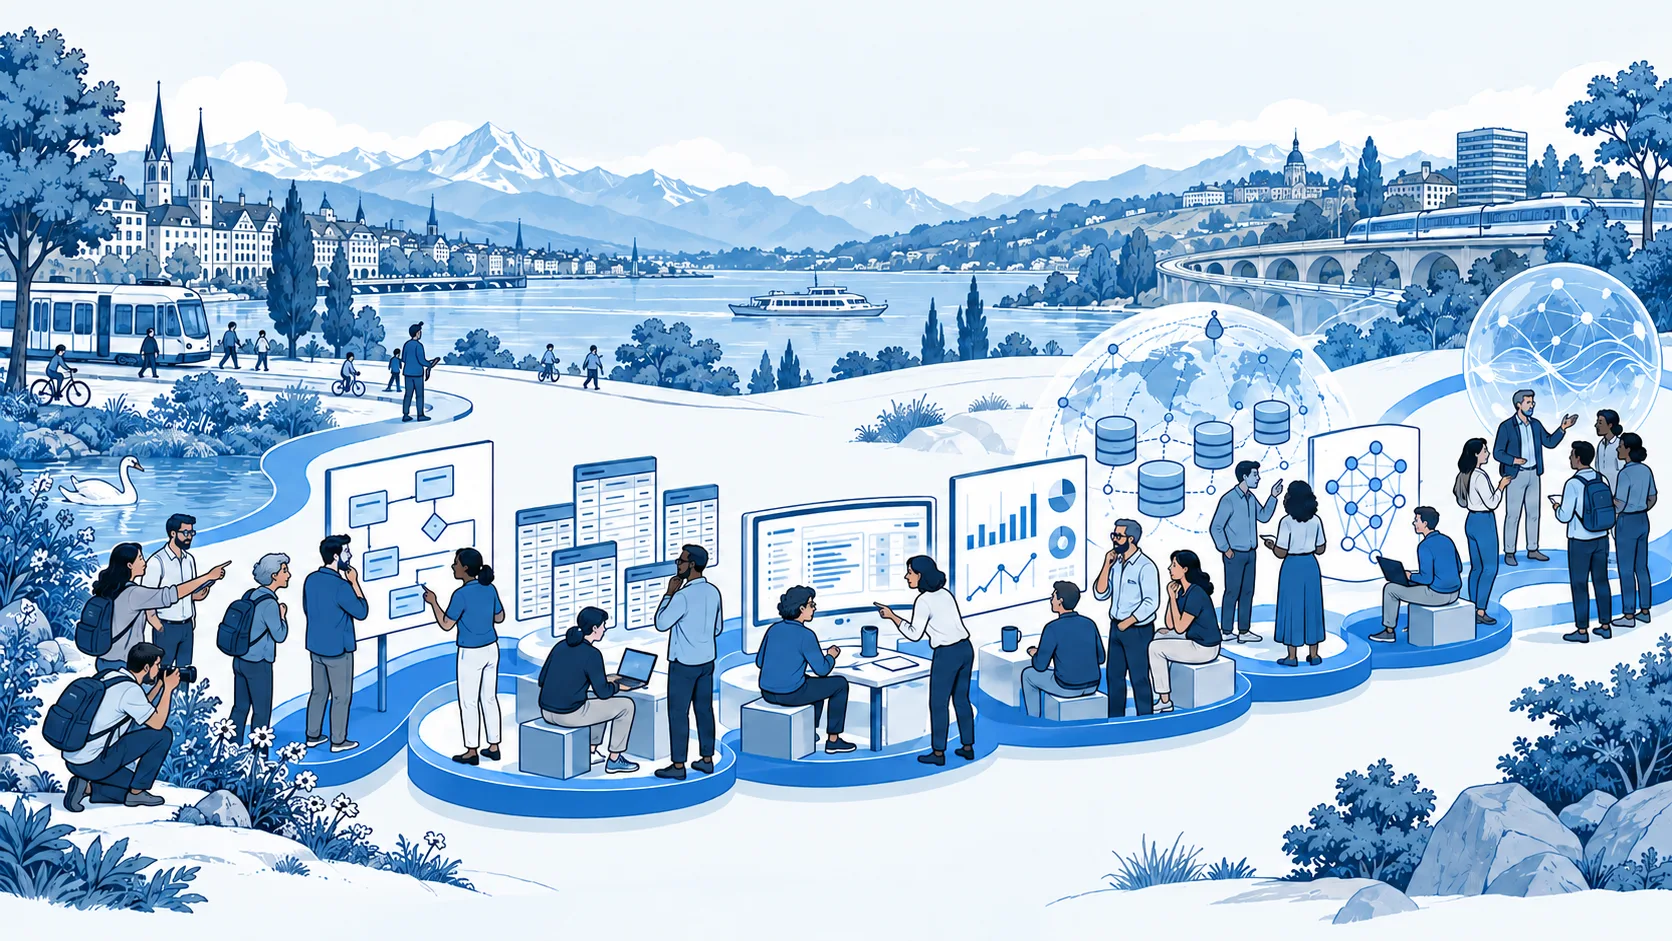
Weshalb wir nicht mit KI beginnen
Generative AI ist sichtbar, leicht zugänglich und faszinierend. Sie vermittelt schnell den Eindruck, fehlende Grundlagen überspringen zu können. Doch eine sprachlich überzeugende Antwort ist noch lange keine verlässliche Antwort.
Unklare Begriffe führen zu widersprüchlichen Datenmodellen. Fehlerhafte Daten führen zu falschen Kennzahlen. Ungeeignete Trainingsdaten können Modelle verzerren. Und fehlen klare Verantwortlichkeiten, will am Ende niemand für das Ergebnis zuständig sein.
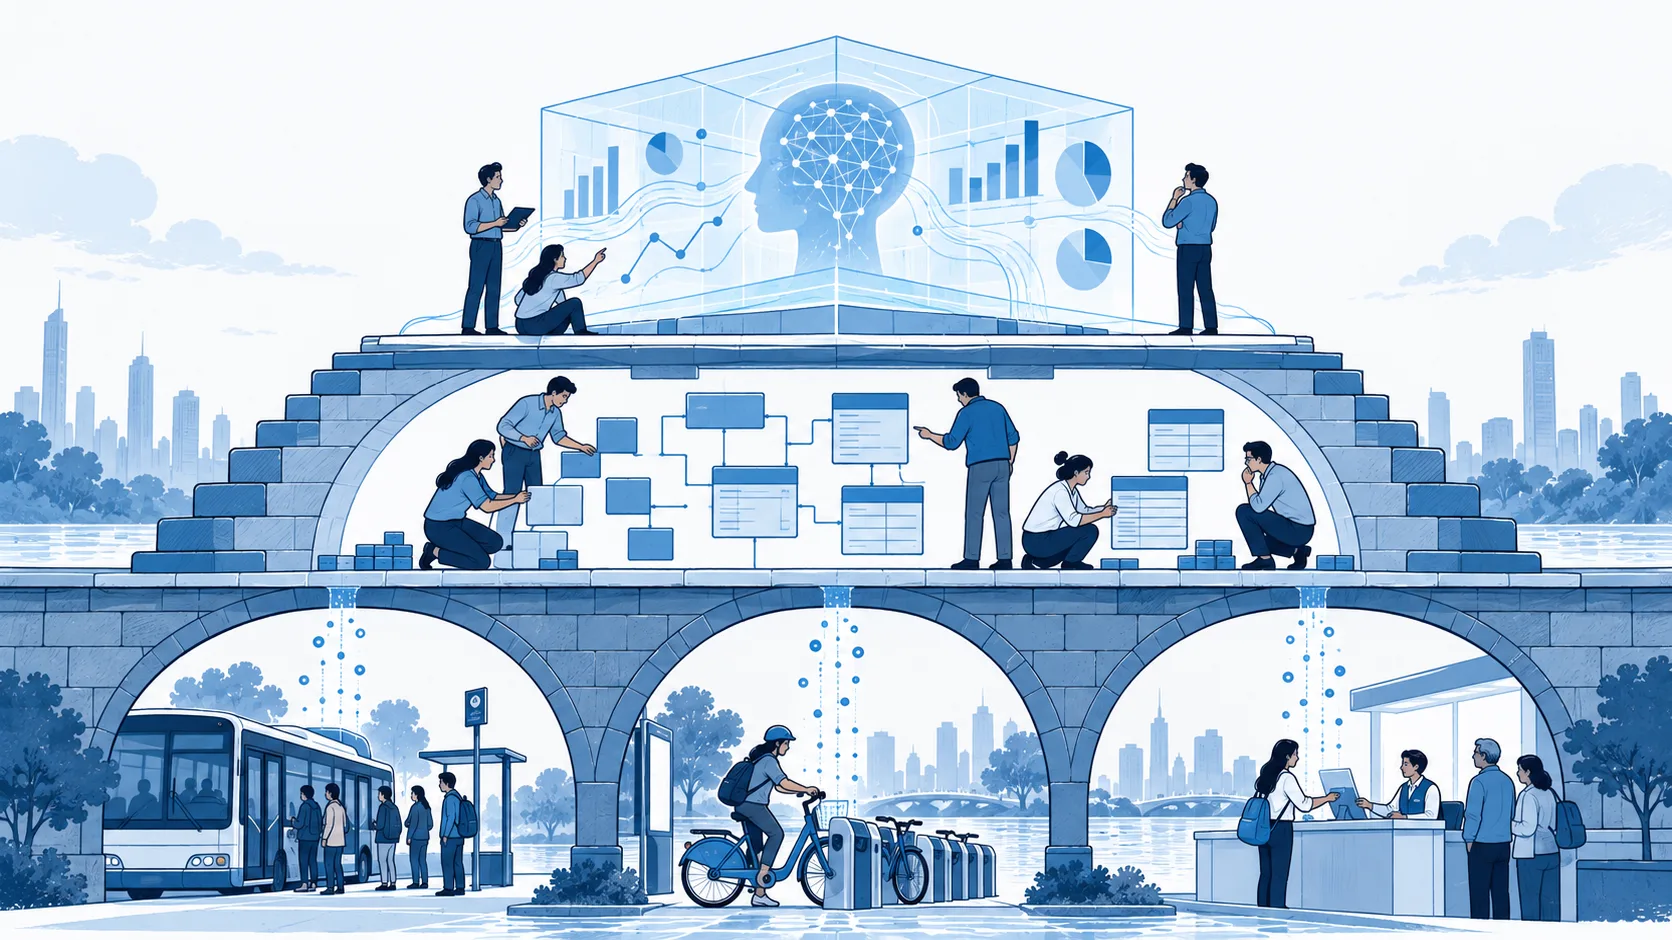
Deshalb beginnt das Modul nicht beim Prompt, sondern bei einer einfacheren Frage: Welchen Ausschnitt der Realität wollen wir verstehen, und welche Daten benötigen wir dafür?
Der rote Faden durch acht Levels
Die acht Levels sind keine voneinander getrennten Themenblöcke. Jedes Level löst ein Problem, das für das nächste geklärt sein muss.
Wir beobachten zuerst einen Ausschnitt der Realwelt. Danach übersetzen wir ihn in ein Datenmodell, bauen daraus relationale Tabellen und greifen mit SQL auf die gespeicherten Daten zu. Im Data Warehouse werden die Daten für Analysen zusammengeführt. Big-Data-Konzepte zeigen, was geschieht, wenn Umfang, Geschwindigkeit und Vielfalt zunehmen. Machine Learning nutzt die Daten für Muster und Prognosen. Generative AI erweitert schliesslich die Möglichkeiten der Interaktion und Automatisierung.
Die Leitfrage bleibt gleich: Wie gelangen wir von Daten zu einer nachvollziehbaren und verantworteten Entscheidung?
Lösungsskizze: Die Lernreise
Der Aufbau folgt vier aufeinander abgestimmten Phasen. Die Technologie verändert sich, die fachliche Verantwortung bleibt bestehen. Ergebnisse werden geprüft und in die Praxis zurückgeführt.
Skizze · Die Lernreise
Verstehen
Realwelt abgrenzen und Datenqualität beurteilen.
Strukturieren
Modelle, Tabellen und verbindliche Regeln entwickeln.
Analysieren
Daten abfragen, zusammenführen und skalieren.
Verantworten
Modelle und generierte Resultate prüfen und begründet einsetzen.
Die acht Levels im Überblick
| Level | Fachlicher Fokus | Zentrale Frage |
|---|---|---|
| 1 · Realwelt | Diskurswelt, DIKW, Datenarten und Datenqualität | Was beobachten wir – und was lassen wir bewusst weg? |
| 2 · Datenmodell | Entitäten, Attribute, Beziehungen und Kardinalitäten | Wie bilden wir fachliche Regeln nachvollziehbar ab? |
| 3 · Relationale Tabellen | Schlüssel, Integrität, Constraints und Normalisierung | Wie verhindern wir Widersprüche bereits in der Struktur? |
| 4 · SQL | Filtern, Verknüpfen, Gruppieren und Aggregieren | Beantwortet die Abfrage wirklich die fachliche Frage? |
| 5 · Data Warehouse & BI | Sternschema, Granularität, Dimensionen und Kennzahlen | Wie entsteht aus Daten eine vergleichbare Information? |
| 6 · Big Data | Fünf V, Skalierung, NoSQL, CAP und Datenplattformen | Welche Architektur ist unter den gegebenen Bedingungen tragfähig? |
| 7 · Machine Learning | Features, Labels, Training, Güte und Bias | Welche Fehler macht das Modell, und wer trägt deren Folgen? |
| 8 · Generative AI | Sprachmodelle, Prompting, RAG, Agenten und Governance | Wie nutzen wir generierte Resultate nachvollziehbar und verantwortlich? |
Von der Realität zur Handlung
| Beobachten | Strukturieren | Auswerten | Entscheiden | Lernen |
|---|---|---|---|---|
| Reale Ereignisse und Bedürfnisse erfassen | Begriffe, Beziehungen und Regeln klären | Daten in Kontext setzen und Muster erkennen | Optionen und Konsequenzen beurteilen | Wirkung prüfen und Grundlagen anpassen |
Lernen durch Anwenden und Widerlegen
Das Modul verbindet fachliche Grundlagen mit praktischer Arbeit. Die Studierenden modellieren, erstellen Tabellen, schreiben SQL-Abfragen, definieren Kennzahlen und beurteilen KI-generierte Vorschläge.
Ein KI-Lerncoach begleitet die Reise als Sparringspartner. Er darf Entwürfe erstellen, Fragen stellen und alternative Lösungen vorschlagen. Seine Antworten werden jedoch nicht ungeprüft übernommen. Die eigentliche Kompetenz zeigt sich darin, Annahmen zu erkennen, Resultate zu prüfen und eine Abweichung fachlich zu begründen.
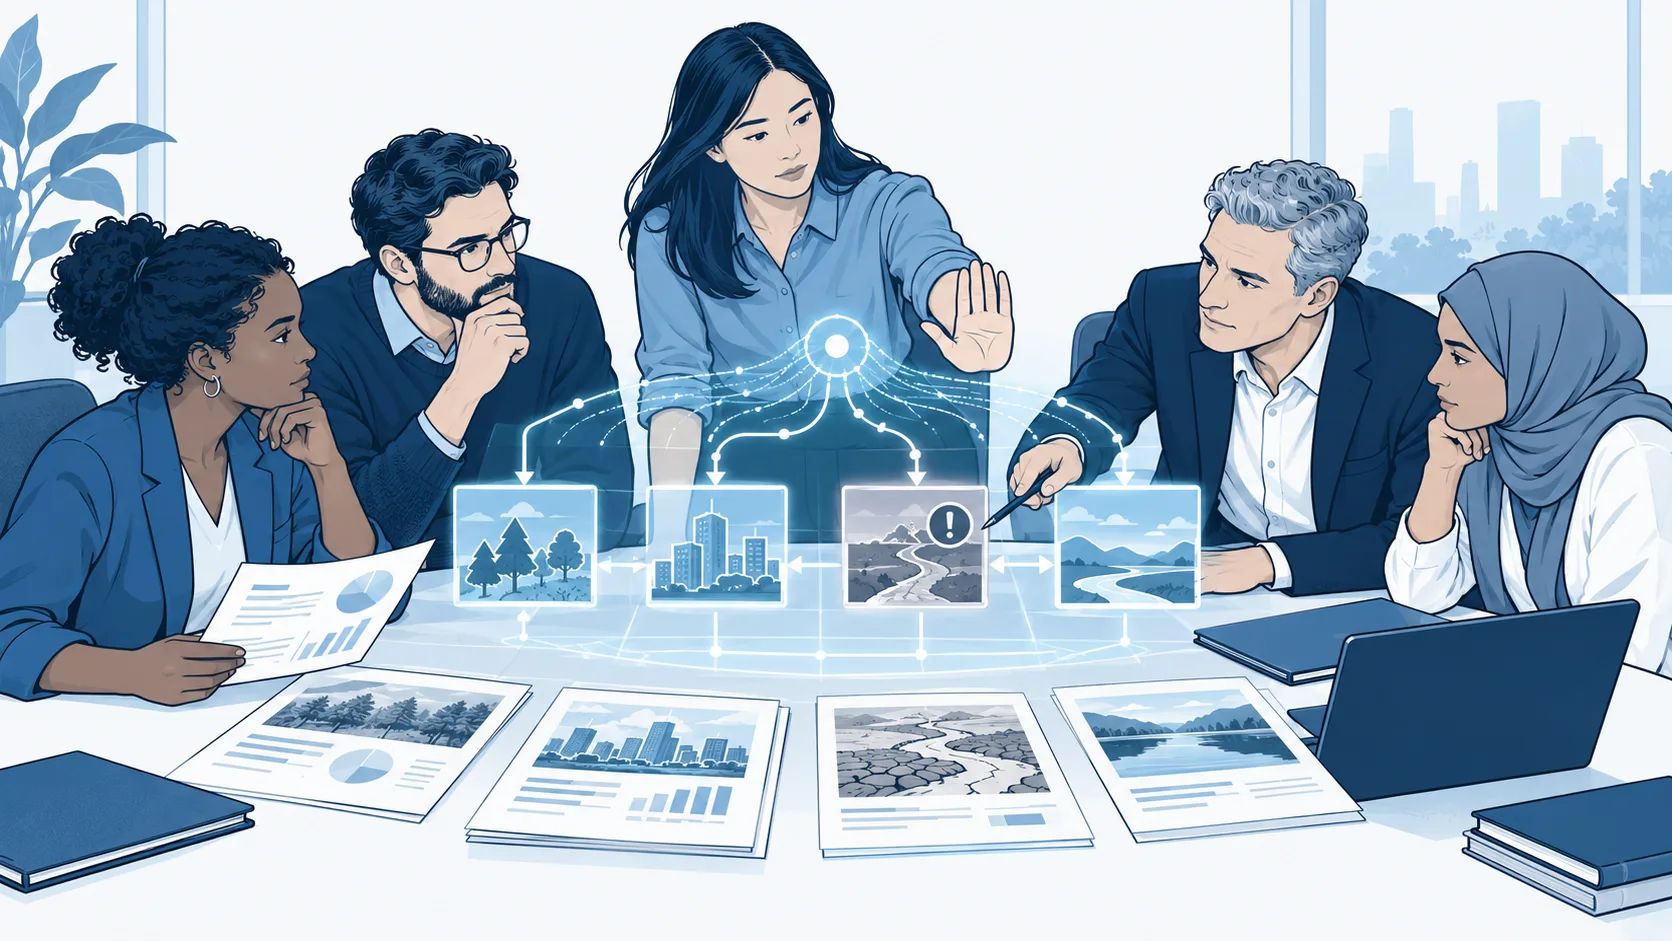
Der Prüfkreislauf bleibt in jedem Level gleich: Aufgabe verstehen, Lösung entwickeln, Ergebnis prüfen, Annahmen begründen, Konsequenzen beurteilen und die Erkenntnisse auf eine neue Situation übertragen.
Ein Praxisfall verbindet die Inhalte
Ein wiederkehrender Praxisfall aus der Mobilität macht die Abhängigkeiten zwischen den Levels sichtbar. Offene Daten von opendata.swiss können helfen, zwischen Rohdaten, Kontext und Aussage zu unterscheiden. Daraus entsteht schrittweise ein Datenmodell, eine relationale Struktur, eine SQL-Auswertung und später eine analytische oder KI-gestützte Anwendung. [1]
Datenschutz und Verantwortung werden dabei nicht auf das letzte Level verschoben. Personendaten, Zweckbindung und Datenminimierung sind bereits bei der Auswahl und Modellierung von Daten relevant. Das Bundesgesetz über den Datenschutz bildet dafür eine verbindliche Schweizer Grundlage; je nach Praxisfall können weitere Vorgaben hinzukommen. [2]
Mein Fazit
Big Data und Künstliche Intelligenz sind kein Sammelsurium moderner Technologien. Sie bilden eine zusammenhängende Wirkungskette.
Wer KI verantwortungsvoll einsetzen will, muss verstehen, woher ihre Daten kommen, wie sie strukturiert wurden und welche Annahmen in den Ergebnissen stecken. Erst dann wird aus einem technisch möglichen Resultat eine belastbare Grundlage für menschliche Entscheidungen.
Der rote Faden lautet deshalb: Von der Realität zu den Daten. Von den Daten zur Erkenntnis. Von der Erkenntnis zur verantworteten Handlung.
Quellen
Verwandte Artikel
Digitaler Staat & Wirkung · Erstveröffentlicht 10. November 2026 · Aktualisiert 11. November 2026
Digitale Verwaltung: Wird der Behördenkontakt einfacher?
Digitale Verwaltung muss sich daran messen lassen, ob Menschen und Unternehmen ihre Anliegen einfacher erledigen können. Mein neuer Wirkungsmonitor verbindet ausgewählte Schweizer Daten mit einer offenen Frage: Welche Entlastung lässt sich tatsächlich belegen?
Lesen · ca. 5 Min.
Digitaler Staat · Erstveröffentlicht 20. Oktober 2026 · Aktualisiert 22. Oktober 2026
Digitale Justiz: Nicht alles muss zentral sein – aber das Gemeinsame muss verbindlich sein
Am CASEDOC Swiss Justice Forum 2026 im KKL Luzern wurde viel über Plattformen, Fachapplikationen, elektronische Akten, KI und neue Betriebsmodelle gesprochen. Mein stärkster Eindruck nach den verschiedenen Perspektiven ist aber ein anderer: Die Schweizer Justiz hat weniger ein Technologieproblem als ein Problem des Zusammenspiels.
Lesen · ca. 5 Min.
KI & Digitale Souveränität · Erstveröffentlicht 18. Oktober 2026 · Aktualisiert 22. Oktober 2026
KI entwickelt unsere Software. Wie souverän macht uns das?
KI kann uns unabhängiger von fertigen Softwareprodukten machen und zugleich neue Abhängigkeiten schaffen. Entscheidend ist, ob wir den erzeugten Code auch ohne das ursprüngliche Modell verstehen, verändern und betreiben können.
Lesen · ca. 9 Min.