Warum ich von Information Drift spreche
In meinem Artikel vom 16. September 2026 habe ich beschrieben, wie Informationen durch wiederholtes Zusammenfassen und Weiterverarbeiten ihren Kontext verlieren können. Dafür verwende ich die Bezeichnung «Information Drift». Sie ist mein beschreibender Begriff, kein hier behaupteter wissenschaftlicher Standard. [1]
Mich interessiert dabei weniger der offensichtliche Fehler als die kleine Verschiebung. Ein begrenzter Befund wird zu einer allgemeinen Aussage. Eine Empfehlung erscheint später als beschlossene Massnahme. Eine mögliche Wirkung wird zur versprochenen Einsparung. Der Text klingt zunehmend eindeutig, obwohl der ursprüngliche Beleg diese Sicherheit nicht trägt.
Ein besonders tückischer Fall entsteht, wenn mehrere Texte auf dieselbe Quelle zurückgehen. Verschiedene Fundstellen können dann den Eindruck unabhängiger Bestätigung erwecken. Ob diese Abhängigkeit tatsächlich vorliegt, muss für die konkrete Aussage geprüft werden. Die Zahl der Suchtreffer allein beantwortet die Frage nicht.
Herkunft nachvollziehen ist noch kein Wahrheitsbeweis
Ich halte nachvollziehbare Herkunft für eine wichtige Voraussetzung guter Quellenarbeit. Sie zeigt, welches Original verwendet und welche Bearbeitung vorgenommen wurde. Danach beginnt die inhaltliche Prüfung: Belegt die Quelle genau den Satz, den ich veröffentlichen oder zur Entscheidung verwenden möchte?
Diese Grenze benennt auch der C2PA-Explainer. Content Credentials können Herkunft und Veränderungen digitaler Inhalte dokumentieren und ihre Integrität prüfbar machen. Daraus folgt kein automatischer Nachweis, dass der Inhalt wahr oder sachlich korrekt ist. Die technische Herkunftsdokumentation ergänzt die Quellenkritik; sie ersetzt sie nicht. [2]
Ein amtliches Dokument ist beispielsweise eine geeignete Quelle für die darin enthaltene amtliche Aussage. Es belegt nicht jede Interpretation, die ein späterer Text daraus ableitet. Ebenso kann eine Studie zuverlässig dokumentiert sein, ohne die von einem Blog behauptete allgemeine Wirkung zu untersuchen. Autorität, Aussage und Übertragbarkeit müssen zusammen geprüft werden.
Mein Ansatz: die Aussage bis zum Ursprung prüfen
Ich empfehle, nicht den ganzen Text gleich intensiv zu prüfen, sondern zuerst seine tragenden Behauptungen. Welche Zahl, welcher Beschluss oder welcher Wirkungsnachweis entscheidet darüber, ob die Empfehlung plausibel ist? Formuliere diese Behauptung präzise. Ein unscharfer Satz lässt sich auch mit einer langen Quellenliste schlecht kontrollieren.
Verfolge anschliessend die Fundstellen zurück. Handelt es sich um Originalmaterial, eine eigene Auswertung oder eine Zusammenfassung? Wenn mehrere Artikel dieselbe Studie oder Medienmitteilung verwenden, notiere diese gemeinsame Herkunft. Eine Kopie kann beim Zugang helfen. Sie ist deshalb aber keine zusätzliche unabhängige Untersuchung.
Prüfe dann die Aussage im Originalkontext. Stimmen Zeitraum und Bezugsgrösse? Geht es um einen Vorschlag, eine Beobachtung oder ein gemessenes Ergebnis? Welche Einschränkung nennt die Quelle? Wenn der entscheidende Inhalt nicht zugänglich ist, muss diese Lücke sichtbar bleiben. Eine plausibel klingende KI-Antwort darf den fehlenden Originalbeleg nicht ersetzen.
Für interne Wissensbestände würde ich Originale, geprüfte Ableitungen und ungeprüfte Entwürfe unterscheidbar ablegen. Ein KI-System sollte diese Unterschiede nutzen können. Wenn ein neuer Text auf früheren Zusammenfassungen aufbaut, braucht er eine nachvollziehbare Quellenlinie und fachliche Prüfung, bevor er wieder zum verbindlichen Wissensbestand wird.
Lösungsskizze: eine prüfbare Quellenlinie
Ziel: Eine entscheidungsrelevante Behauptung wird auf ihre tatsächlichen Belege zurückgeführt. Ausgangslage: Mehrere Dokumente und KI-Ableitungen sind vorhanden, ihre Beziehungen sind unklar.
Vorschlag: Die verantwortliche Person erfasst Behauptung, Originalquelle, Fundstelle, Datum, Einschränkung und Prüfstatus. Zusammenfassungen verweisen auf das Original. Ungeprüfte Texte bleiben als Entwürfe erkennbar. Ressourcen: Zugang zu den Quellen, fachliche Prüfzeit und eine einfache gemeinsame Ablage; für den Einstieg ist kein neues Grosssystem nötig.
Erfolg erkennbar an: nachvollziehbaren Originalbelegen, erhaltener Unsicherheit und einer dokumentierten Korrektur, wenn eine Ableitung zu weit geht. Hauptrisiko: Herkunft wird mit Richtigkeit verwechselt. Gegenmassnahme: Quellenlinie und inhaltlichen Claim-Check getrennt durchführen.
Skizze · Quelle und Aussage getrennt prüfen
Behauptung
Den entscheidenden Satz präzise bestimmen.
Ursprung
Originale und gemeinsame Quellenlinien finden.
Claim-Check
Kontext, Belegkraft und Grenzen kontrollieren.
Freigabe
Belegt, eingeschränkt oder nicht verifiziert ausweisen.
Ein kleiner Claim-Check mit grosser Wirkung
Mein Prüfraster lautet CRAP: Currency, Reliability/Relevance, Authority und Purpose. Ich frage nach Aktualität, konkreter Belegkraft, fachlicher Zuständigkeit und Zweck der Quelle. Diese vier Fragen beziehen sich auf die einzelne Aussage. Ein seriöser Absender gibt einem ganzen Text keinen pauschalen Wahrheitsstempel.
Ein hypothetisches Beispiel: Eine Präsentation verspricht eine bestimmte Einsparung durch KI. Als Beleg nennt sie drei Artikel. Alle führen zu derselben Herstellerfallstudie. Das macht die Fallstudie nicht automatisch wertlos. Es bedeutet aber, dass drei Veröffentlichungen hier nicht drei unabhängige Messungen sind. Zusätzlich wären Ausgangslage, vollständige Kosten und Vergleichbarkeit zu prüfen.
Prüfaufwand muss verhältnismässig bleiben. Eine interne Ideensammlung braucht eine andere Tiefe als eine öffentliche Aussage mit einer konkreten Zahl. Ich würde die Prüfung deshalb am möglichen Schaden und an der Bedeutung für die Entscheidung ausrichten. Bei wesentlichen Behauptungen gehört die Unsicherheit in die Entscheidungsvorlage.
Mein praktischer Einstieg ist bewusst einfach: Nimm eine zentrale Aussage aus deinem nächsten Text und suche ihren Ursprung. Wenn du ihn nicht findest, kennzeichne die Aussage als nicht verifiziert. Wenn du ihn findest, prüfe, ob dein Satz noch das Gleiche sagt. Diese Gewohnheit ist für mich eine tragfähige Grundlage verantwortlicher KI-Nutzung.
Quellen
Verwandte Artikel
Digitaler Staat & Wirkung · Erstveröffentlicht 10. November 2026 · Aktualisiert 11. November 2026
Digitale Verwaltung: Wird der Behördenkontakt einfacher?
Digitale Verwaltung muss sich daran messen lassen, ob Menschen und Unternehmen ihre Anliegen einfacher erledigen können. Mein neuer Wirkungsmonitor verbindet ausgewählte Schweizer Daten mit einer offenen Frage: Welche Entlastung lässt sich tatsächlich belegen?
Lesen · ca. 5 Min.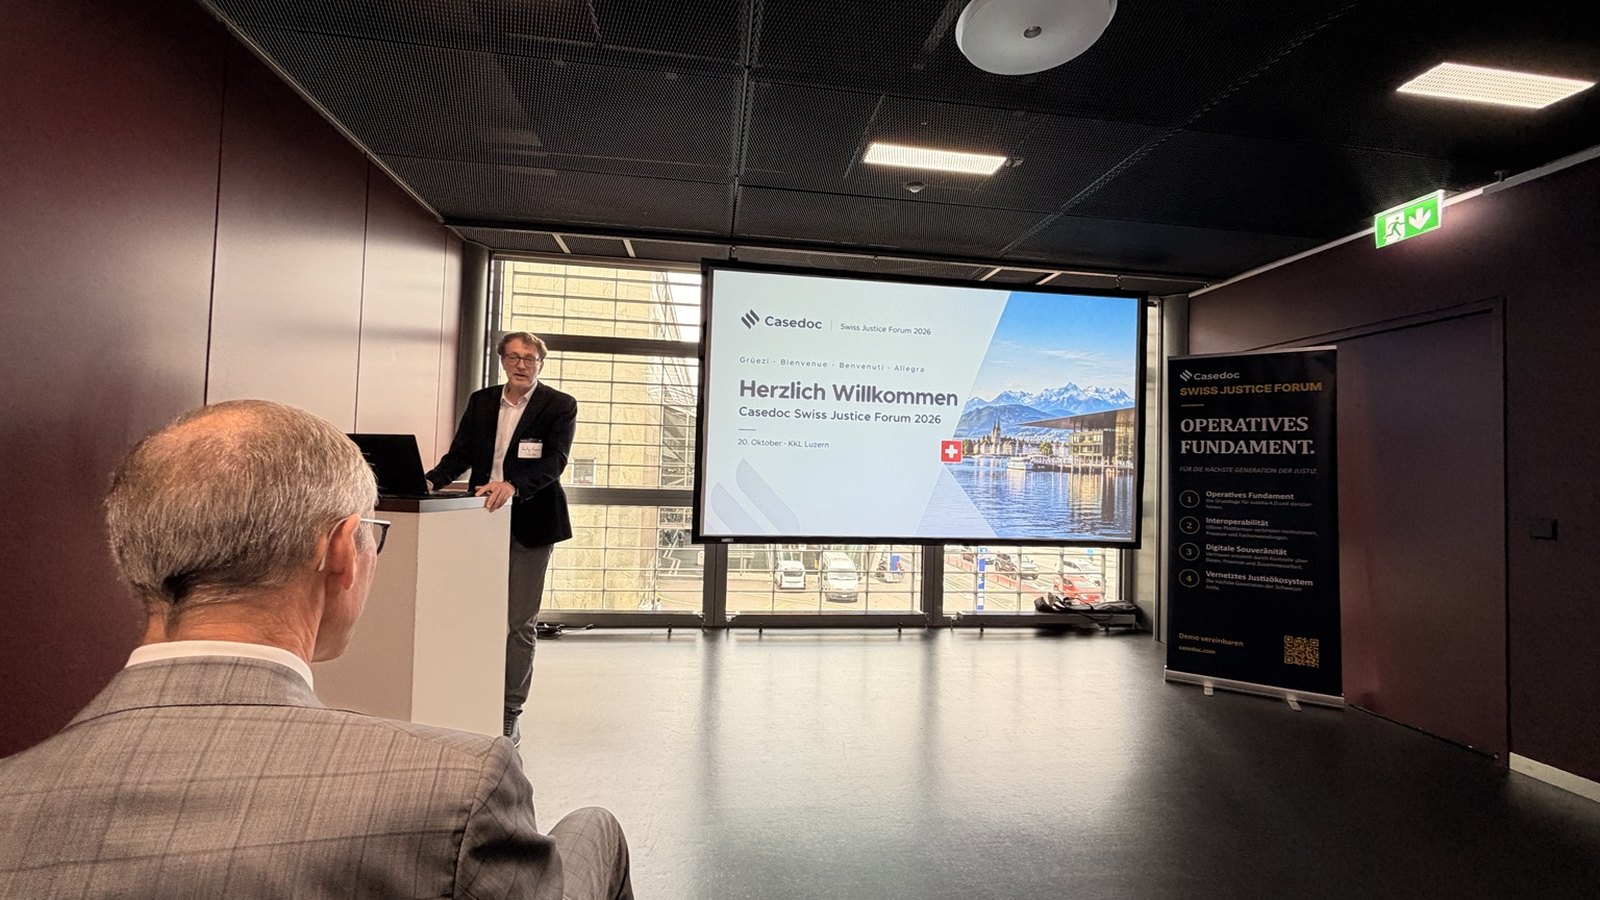
Digitaler Staat · Erstveröffentlicht 20. Oktober 2026 · Aktualisiert 22. Oktober 2026
Digitale Justiz: Nicht alles muss zentral sein – aber das Gemeinsame muss verbindlich sein
Am CASEDOC Swiss Justice Forum 2026 im KKL Luzern wurde viel über Plattformen, Fachapplikationen, elektronische Akten, KI und neue Betriebsmodelle gesprochen. Mein stärkster Eindruck nach den verschiedenen Perspektiven ist aber ein anderer: Die Schweizer Justiz hat weniger ein Technologieproblem als ein Problem des Zusammenspiels.
Lesen · ca. 5 Min.
Big Data & AI · Erstveröffentlicht 18. Oktober 2026
Big Data & AI: Vom Ereignis zur verantworteten KI.
Künstliche Intelligenz steht am Ende einer längeren Wirkungskette. Erst wenn wir reale Vorgänge abgrenzen, Daten strukturieren, speichern und richtig interpretieren, entsteht eine belastbare Grundlage für Analyse, Machine Learning und Generative AI.
Lesen · ca. 3 Min.